Показаны сообщения с ярлыком disk. Показать все сообщения

понедельник, 25 сентября 2017 г.

Восстанавливаем файловую систему загрузочного диска ESXi

Столкнулся с проблемой установки/обновления VMware Tools на машинах, работающих на одном из хостов в кластере:


С машинами, работающими на других хостах кластера такой проблемы нет, можно без ошибок установить/обновить VMware Tools.
После прочтения, предложенного в сообщении об ошибке KB Installing and upgrading the latest version of VMware Tools on existing hosts, подключился по SSH к проблемному хосту и обнаружил следующую картину:


Файловая система раздела, содержащего VMware Tools разрушена.
Первая мысль переустанавливать ESXi с нуля, но подумав пару минут, пришло осознание, ESXi все-таки Linux и должен быть путь «починить» файловую систему раздела без полной переустановки ESXi.

Возможно, данная проблема связана с KB High frequency of read operations on VMware Tools image may cause SD card corruption.
Начиная с ESXi 6.0 U3 появился дополнительный параметр, который позволяет при загрузке ESXi создать RAM диск, содержащий образы VMware Tools. Это снизит нагрузку на загрузочный диск при многократной установке VMware Tools.

Итак, первым делом выводим хост в Maintenance Mode.
Далее, нужно понять какой раздел смонтирован в папку /store (locker – это ссылка на store). Для это этого выполним команду:
vmkfstools -P /store
Обычно это 8 раздел загрузочного устройства (почему 8 раздел можно прочитать в статье Загрузка ESXi c USB/SD и что меняется, когда появляется vSAN):


Запускаем проверку диска для 8 раздела загрузочного диска:
dosfsck -a -w /dev/disks/mpx.vmhba32:C0:T0:L0:8
Бывает, что требуется ручное исправление ошибок на диске, тогда:
dosfsck -v -w -r /dev/disks/mpx.vmhba32:C0:T0:L0:8
Далее, удаляем содержимое папки /store и перезагружаем проблемный хост:
rm -r /store/*
При загрузке ESXi восстановит необходимые файлы и папки в store, но vib пакет с VMware Tools нам придется восстановить руками, можно это сделать, например, через Update Manager:


К сожалению, я сталкивался с ситуациями, когда USB/SD карты выходили из строя или «ломались» партиции на них. Вообщем, разбираться и «чинить» точно бы заняло кучу времени.
На этот случай есть возможность создания резервной копии конфигурации ESXi и последующего восстановления из нее. Все это описано в KB How to back up ESXi host configuration. Данная процедура работает и для хостов с VMware vSAN без необходимости эвакуировать данные с проблемного хоста.

Делаем резервную копию конфигурации, например, через PowerCLI:
Connect-VIServer -Server host_ip
Get-VMHostFirmware -VMHost host_ip -BackupConfiguration -DestinationPath C:\Temp
Переустанавливаем ESXi с нуля. И восстанавливаем настройки из резервной копии:
Connect-VIServer -Server host_ip
Set-VMHost -VMHost -State 'Maintenance'
Set-VMHostFirmware -VMHost host_ip -Restore -SourcePath C:\Temp\configBundle host_ip.tgz -HostUser root -HostPassword Password

вторник, 5 мая 2015 г.

vVNX Community Edition

EMC опубликовала бесплатный полнофункциональный виртуальный VNX с ограничением до 4ТБ емкости. Поддерживается функционал vVols - соотв. это отличный способ попробовать их на практике.

Фактически это код от VNXe 3200, доступен в формате OVA и требует среду VMware.

http://www.emc.com/products-solutions/trial-software-download/vvnx.htm

вторник, 10 февраля 2015 г.

Техническое описание VVol

Первое что хотелось бы отметить - технология называется VVol, не vVol, Vvol и прочее (от переводчика).


Традиционные системы хранения данных имеют следующие недостатки:
  • Специализированное и дорогое железо - не общедоступное, стандартное оборудование, низкая утилизация и переподписка (overprovisioning);
  • Архитектуру от устройства - статические уровни предоставления качества, стандартизированное выделение ресурсов, невозможность гранулярного контроля;
  • Сложные процессы - недостаточность автоматизации, затратные по времени процессы, медленная скорость реакции на запросы.
Гипервизор позволяет реализовать автоматизацию СХД от приложения, так как:
  • Знает все требования приложений в реальном времени;
  • Является элементом пути в операции ввода-вывода;
  • Видит все нижележащие СХД;
  • Может динамически настраивать СХД;
  • Независим от аппаратного обеспечения.
Традиционная модель - длительные циклы предоставления ресурсов, управление LUN, сложные и частые миграции данных.

Автоматизация от приложения - динамическое предоставление ресурсов СХД по мере необходимости. Контроль уровня предоставления сервиса на уровне отдельной ВМ. Общее управление разными устройствами.


vSphere Virtual Volumes
  • Виртуализирует SAN и NAS устройства;
  • Виртуальные диски нативно предоставляются массиву;
  • Позволяют выполнять операции на уровне отдельной ВМ используя функции СХД;
  • Управление хранилище на основе политик (SPBM, Storage policy-based management) позволяет автоматизировать потребление ресурсов при масштабировании;
  • Широкая поддержка основнымит производителями СХД;
  • Поставляется с vSphere.
Что такое VVol?
  • Пять типов объектов VVols: Config, Data, MEM, SWAP, Other;
  • Отсутствие необходимости использования СХД (VMFS отходит в историю);
  • Объекты виртуальной машины хранятся нативно на СХД;
Контейнер массива (Storage Container)
  • Логическая конструкция массива для группирования виртуальных томов;
  • Обычно определяется администратором СХД на самом массиве для определения ёмкости массива и его ограничений;
  • Ёмкость определяется физической ёмкостью массива.
Разница между контейнерами массива и LUN
  • Размер контейнера основан на ёмкости массива;
  • Максимальное количество контейнеров зависит от массива;
  • Размер контейнера может быть расширен;
  • LUN требует файловой системы, стандартизация размера LUN требует большего их количества.
Протокол конечной точки (Protocol End Points)
  • Точка доступа реализовывающая коммуникацию между ESXi и СХД;
  • На данный момент поддерживаются: iSCSI, NFS v3, FC, FCoE;
  • Для каждой конечной точки единовременно поддерживается какой-то один обозначенный протокол;
  • Конечная точка получает SCSI либо NFS команды;
  • Контейнера массива - для большого количества метаданных и данных ВМ.
Панель управления
  • VASA Provider (VP) - разрабатывается поставщиком СХД;
  • Один VP может управлять несколькими массивами;
  • VASA Provider может быть реализован как внутри массива, так и в виде внешней ВМ;
  • Внеполосной (out of band) обмен сообщениями;
  • ESXi и vCenter Server подключаются к VASA Provider.
Возможности массива и политики хранения ВМ (Storage Capabilities и VM Storage Policies)
  • Являются функциями массива и требованиями ВМ к этим функциям, соответственно. Требования могут быть удовлетворены возможностями, предоставляемыми массивом;
  • Возможности массива определяют что может предоставить массив в ответ на требования ВМ;
  • Политики хранения ВМ являются компонентом хранилища на основе политик
  • Представленные возможности - функции и сервисы массива, предоставленные гипервизору через VASA API;
  • Управляются на уровне виртуального диска ВМ
  • Используют концепцию соответствия для контроля предоставляемого уровня сервиса.
Сценарии операций
  • Разгрузка операций: разворачивание, удаление, клонирование (полное и связанных), снепшоты;
  • Снепшоты: управляемые ESXi или массивом.
В данной версии SRM не поддерживает VVol, но будет в следующей.

В будущих версиях VVol позволит пулу массива распространяться между физическими массивами.

Статья написана на основе доклада Роулинсона Риверы (Rawlinson Rivera) с VMware PEX 2015.
Оригинал: VVol Technical Overview

воскресенье, 29 июня 2014 г.

VMUG 2014 - Проблемы с дисками?


Моя презентация на VMUG Россия 26 июня 2014. Краткий обзор VMware Pluggable Storage Architecture и гайд по траблшутингу подсистемы хранения.

четверг, 27 февраля 2014 г.

Adaptive Queueing против Storage I/O Control

В данном посте мы рассмотрим две разные технологии vSphere по управлению глубиной очереди на ESXi хостах. Очередь определяет количество запланированных операций ввода-вывода, которые могут быть отправлены к СХД. В случае с vSphere, где обычно к одному общему дисковому устройству обращается несколько хостов, может быть полезно управлять глубиной очереди в моменты нехватки ресурсов. В данной статье мы сравним Adaptive Queues и Storage I/O Control (SIOC).

Чем эти технологии отличаются?
SIOC использует концепцию уровня перегруженности основанном на задержках доступа. По сути, если задержки на определённом datastore превысят определённый порог - включится SIOC. Этот порог может быть выставлен вручную (стандартное значение 30мс) или автоматически с помощью инжектора запросов (представлен в 5.1). В случае с адаптивным управлением очередью vSphere ждёт фактического наступления нехватки ресурсов, то есть получения от СХД в ответ на запрос команды ввода-вывода SCSI команды USY или QUEUE FULL.

Какой механизм когда работает?
Обе технологии урезают глубину очереди. В случае с SIOC каждая ВМ на datastore имеет своё значение долей (shares), при этом сами ВМ могут быть на разных хостах. Когда порог превышен доступ к LUN начинает контролироваться путём управления глубиной очереди для каждого отдельного хоста, но при этом учитываются доли каждой отдельной ВМ. Возьмём, к примеру, два хоста с двумя ВМ на каждом. Если доли ВМ на первом хосте будут по 1000, а на втором по 2000, то второй хост сможет отправить в два раза больше команд в момент нехватки ресурсов. Как только ситуация нормализуется - все хосты и ВМ смогут отправлять данные без ограничений глубины очереди, и SIOC перестанет ограничивать ресурсы.

Адаптивное управление очередью не настолько гибкое - в случае заполнения очереди команд, глубина очереди хоста к LUN урезается на половину. Поэтому очень важно чтобы на всех хостах подключённых к одному хосту было включено адаптивное управление очередью. Включение данной функции только на части хостов приведёт к серьёзному падению производительности, так как очередь будет зарезана только у части хостов, а не у всех. Как только очередь будет обработана - она снова инкрементально начнёт заполняться.

Когда какая технология была представлена?
SIOC впервые был представлен в vSphere 4.1 для блочных устройств и в vSphere 5.0 для NAS. Адаптивное управление очередью - в ESX 3.5U4.

Как включить данные технологии?
SIOC включается в свойствах каждого отдельного хранилища. По умолчанию данная функция выключена. Данная функция доступна только в редакции Enterprise+.

Для включения адаптивного управления очередью необходимо в расширенных настройках каждого отдельного хоста перейти в раздел Disk, и изменить значение параметров Disk.QFullSampleSize и Disk.QFullThreshold. По умолчанию параметр QFullSampleSize имеет значение 0, то есть выключено, а QFullThreshold редактирует необходимое количество команд о нормализации статуса для снятия блокировки.

Итоги
Каждая функция может принести свою пользу в вашей инфраструктуре. SIOC, по сравнению с адаптивной глубиной очереди, более гибкая технология, но и доступна она только в Enterprise+. Но, в свою очередь, адаптивная очередь требует настройки на каждом отдельном хосте. Также если порты СХД используются для работы с другими ОС, не только vSphere, я рекомендую прочитать следующую статью базы данных: 1008113.

Типы архитектур систем хранения данных

Это не новая тема, я её уже освещал на VMworld 2013 на сессии STO5420. Хранилища (такие штуки которые хранят информацию, и делают разные вещи с информацией) можно разделить на 4 группы. Главное здесь не зациклиться на не основных вещах.

Люди мысленно разделяют хранилища по их физическим свойствам типа интерконнекта (они все используют Infiniband!), протоколу (блочная СХД! Или NFS! Или мультипрокольная!) или даже аппаратное это или только программное решение (это просто софт на сервере!).

Это все не правильная таксономия и неправильный способ группировки! Программная архитектура - вот главный принцип группировки, так как именно по нему определяются фундаментальные характеристики. Все остальные элементы - частности реализации архитектуры.

Поймите меня правильно - они важны, но не фундаментальны.

Тип 1. Кластеризованная архитектура (вертикально масштабируемые решения)
Такие решения характеризуются тем, что в них не используется общая память между контроллерами, и, по сути, данные находятся в кэше одного контроллера. СХД может быть A/A (оба контроллера активны), A/P (один контроллер пассивен), A/S (каждый контроллер обрабатывает свой объём данных, то есть у контроллеров ассиметричный доступ к данным).

Обработка данных такими СХД выглядит так:
Плюсы:
  • Задержка между контроллерами минимальна. Практически нулевая.
  • Скорость работы массива зависит от дисков.
  •  Так как задержки в таких решениях минимальны, то СХД идеальны для транзакционной модели доступа к данным.
  • Простая архитектура и минимальные коммуникации между контроллерами делают архитектуру очень легко расширяемой функционально (компрессия, дедупликация, тиринг).
  • Легко поддерживать, управлять, настраивать.
Минусы:
  •  Масштабируемость ограничена мощностью контроллера или парой. Обычно до 1000 дисков.
  • Доступность данных гарантируется переключением между контроллерами. Что может привести к понижению производительности при выходе одного из строя.
Точки отказа:
  •  Сам контроллер и его компоненты - железо и ПО.
  • Диски, порты в фабрике и т.д.
Примеры:
  • Active/Standby- Nimble, Pure Storage, Tintri, UCS Whiptail
  • Active/Passive- NetApp, EMC VNX*
  • Active/Active- HDS HUS, Dell Compellent, EMC VNX*, IBM V7000
 Сюда же попадает все PCIe решения типа Fusion-IO или EMC XtremCache только без отказоустойчивости. Если это решение использует специализированное ПО для обеспечения отказоустойчивости, распределённого хранилища данных, целостности данных - смотрите на ПО, оно попадает под одну из четырёх архитектур.

Поверх такого можно поставить федеративное решение, чтобы сделать их более горизонтально масштабируемыми с точки зрения управления. Однако IO будет балансироваться ровно до попадания данных на контроллер. Такие решения также могут использоваться для балансировки между контроллерами и пулами (VDM Mobility у VNX и Clustered ONTAP у NetApp). Как по мне, такое решение можно с натяжкой назвать горизонтально масштабируемым. Так как данные, так или иначе, находятся за одним или другим контроллером. Балансировка и тюнинг важны, в отличие от архитектур 2 и 3, где она просто есть.

Тип 2. Слабо связанные (горизонтально масштабируемые решения)
Архитектурно звучит как самое простое решение, хотя на самом деле, это самое сложное решение. Такое решение тоже не использует общую память между нодами, но сами данные распределены по множеству нод. Также такому решению характерно большое количество коммуникаций между нодами при записи данных (дорогая операция с точки зрения задержек). Но они всё равно транзакционны - записи хоть и распределены, но все консистентны.

Заметьте на картинке нода обозначена без отказоустойчивости, считается что устойчивость гарантируется распределённостью и копиями данных.

Обычно задержки в таких массивах прячут за хранилищем с низкой латентностью (NVRAM, SSD и т.д.), но в любом случае всегда больше задач по балансировке и копирования данных чем в обычном кластере типа 1 так как операции записи распределённые.

Иногда выделяется группа нод, хранящая только метаданные об остальных нодах. Логика сходна с федерацией в предыдущей архитектуре.

Преимущество такой архитектуры в простоте масштабирования и управления. Горизонтальное масштабируемые системы просто идеальны для транзакционных нагрузок так как из-за распределённой природы таких систем можно использовать не отказоустойчивые сервера не связанные между собой, с чем отлично справится старый добрый Ethernet.

Несмотря на то, что способы интерконнекта могут отличаться (Ethernet, Infiniband и тд), для всех таких решений критичным местом является сеть для распределённой записи данных. Подтверждение о записи будет отправлено инициатору только после успешной записи данных на нескольких разных нодах. Это, в свою очередь, приводит к увеличению зоны отказа. Эти два параметра являются основными ограничивающими масштаб факторами.

Обработка запроса на запись выглядит следующим образом:

 И, соответственно, на чтение:

Плюсы:
  • В конвергентных решения задержки на запись практически нулевые от клиента к массиву. Основные задержки вызывает копирование между нодами
  • Быстрый локальный кэш для минимизации задержек синхронизации
  • Производительность масштабируется практически линейно
  • Отличная производительность при последовательном чтении
  • Практически не используются специализированные аппаратные решения
  • Обычно используются большие пулы ресурсов, что облегчает администрирование
Минусы:
  • Больше нод - больше ресурсов на координацию
  • В случае выхода какого-либо компонента из строя сбойной помечается вся нода
  • Компромисс между производительностью и требованием к объёму данных. Некоторые решения разбивают данные на блоки с хэшами или контрольными суммами, что уменьшает скорость случайного доступа и требование к пространству или используют несколько копий данных, увеличивая требования к пространству
  • Создание дискового пула является сложной фоновой задачей съедающей ресурсы
  • Некоторые приложения не могут использовать все преимущества такой архитектуры, что приводит к локальной высокой нагрузке.
Точки отказа:
  • Все отказы на ноде приводят к полному её отказу.
  • Некоторые решения используют локальные RAID массивы, что приводит к тому что выход локального диска не приведёт к вывод из строя всей ноды.
Примеры:
  • Аппартные решения: EMC Isilon, Dell Equallogic, HP StoreVirtual 4000
  • Программные решения: VMware VSAN, IBM SONAS,  HP StoreVirtual VSA, EMC ScaleIO, VMware Virsto
  • Конвергентные решения: SimpliVity, Nutanix.
Тип 3. Связанные, горизонтально масштабируемые архитектуры
Архитектура, в которой используется общая память между контроллерами (кэш или метаданные), а сами данные разнесены по разным нодам. Огромное количество коммуникаций между контроллерами по любому типу операций.

Общая память является критичным моментом для данной архитектуры. Изначально это позволяло
получить симметричный доступ к данным через любой контроллер. Разрабатывалась так, чтобы при выходе из строя любого элемента (запланированном или нет) операции ввода-вывода оставались относительно сбалансированными.

Несмотря на то, что схема данной архитектуры очень похожа на предыдущую, разница в том что модель распределённого и общего доступа к метаданным означает что такие решения не просто используют Infiniband, а зависят от RDMA для обеспечения общего доступа к метаданным между нодами.

Возьмём к примеру два решения от EMC - Isilon и XtremeIO. Не смотря на то что они оба очень похожи - оба решения горизонтально масштабируемы и оба используют Infiniband для интерконнекта разница в том, что Isilon использует Infiniband для минимизации задержек между нодами, и не использует общей памяти между нодами. Фактически, Isilon может использовать Ethernet (так и есть в VA версии), а XtremeIO зависим от RDMA.

Еще один важный момент отличия между двумя архитектурами: чем больше связанны контроллеры между собой, тем меньше, и предсказуемо меньше, будут задержки, но меньше масштабируемость из-за роста сложности системы.

Операции ввода-вывода выглядят так:

Плюсы:
  • Задержки между контроллерами практически нулевые
  • Задержки записи данных зависят в основном от физических дисков
  • Идеально подходят для высоконагруженных систем
  • Ограничением масштабируемость гарантируется производительность
Минусы:
  •  Масштабируемость ограничена максимальным количеством контроллеров
  • Хотя некоторые системы и используют x86 архитектуру, для них используется собственное аппаратное обеспечение. В остальных случаях используются ASIC. Оба этих фактора приводят к более долгому переходу на новые технологии.
Точки отказа:
  • Архитектура разработана с учётом отсутствия или отказоустойчивости любого элемента.
Примеры:
  • EMC Symmetrix VMAX
  • HDS VSP
  • HP 3Par
Тип 4. Распределённая архитектура без общих элементов (shared nothing)
В распределённых системах не используется общая память, данные разнесены по разным нодам, но не транзакционно, а "лениво". То есть данные записываются на одну ноду, и с определённой периодичностью (иногда) копируются на другие ноды для обеспечения защищённости. Системы данного типа не транзакционны.

Неизбежный интерконнет всегда построен на Ethernet (просто потому что дёшево и всегда доступно), ноды не отказоустойчивы. Корректность данных не всегда обеспечивается СХД, а программным стеком выше с помощью контрольных сумм.

Эта простота делает данную архитектуру самой масштабируемой из всех. У неё абсолютно никакой зависимости от аппаратного обеспечения, и практически всегда выполнена в программном виде. Масштабируется до петабайт с такой же лёгкостью как другие СХД до терабайт.  Обычно используется объектные и non-POSIX файловые системы часто даже лежащие поверх локальных ФС, используемых для базовых задач.

Примеры:
  • HDFS
  • EMC Atmos
  • Блочный доступ в EMC ViPR
  • Amazon AWS S3 (хотя никто за пределами Amazon не знает как на самом деле обстоит дело, я склоняюсь к типу 3)
  • Ceph
  • Openstack Swift
Оригинал: virtualgeek.typepad.com
Оригинал:  vmtyler.com

понедельник, 2 декабря 2013 г.

Не получается подключиться к NFS на Iomega

При попытке создать NFS датастор появляется сообщение
Call "HostDatastoreSystem.CreateNasDatastore" for object "ha-datastoresystem" on ESXi "192.168.X.X" failed.NFS mount 192.168.X.X:/mnt/part2/nfs_vmware failed: Unable to connect to NFS server.
При этом все остальное работает, сеть везде прописана, IP пингуется.

Проблема в том, что Iomega (в моем случае это ix4-200d) пытается отрезолвить DNS в обратную сторону. Ну а поскольку у меня все полегло после переключения питания, а DNS лежит на этой самой Iomega - замкнутый круг.

Решение:
1. Включить Support Mode на Iomega (простыми словами SSH доступ) на странице https://ix4-vadmin/support.html (заменить ix4-vadmin на IP вашей хранилки).
2. SSH на хранилку с логином root, и паролем из вашего административного пароля с добавкой soho в начале. Если пароля нет, значит просто soho.
3. Прописать в /etc/hosts имена ESXi, с которых будете подключаться
...
PROFIT!

пятница, 25 октября 2013 г.

Почему загрузка файлов на VMFS такая медленная?

Мы все видели это множество раз - залить файл на VMFS датастор занимает слишком много времени. Например, ISO с образом Windows 7 заливается 10 минут на iSCSI, и менее минуты на NFS. Оба датастора не имеют проблем и достаточно быстрые, на обоих работают ВМ.

Проблема с VMFS заключается в избыточных операциях с метаданными. Прежде всего, копирование файла блок за блоком вызывает множество обновлений метаданных по мере роста размера файла. Одно из решений - создать большой файл, скопировать его и обрезать по размеру в конце. Поэтому мы рекомендуем использовать vmkfstools для перемещения ВМ между датасторами из командной строки. По мере роста файла кусочками VMFS вынуждена постоянно обновлять метаданные для выделения новой порции ресурсов VMFS. Причем все это нужно для гарантирования целостности данных. В случае с NFS это просто не требуется в связи с принципиально иным механизмом блокировок файлов.

Один из путей подтверждения этого - статистика VAAI для дисковых массивов с поддержкой VAAI, или статистика SCSI reservation для массивов без. В качестве простейшего примера можно использовать gzip большого vmdk файла на VMFS датасторе (множество маленьких операций чтения и записи). Даже для VAAI будет видно множество запросов ATS и ZERO:

ATS ATSF ZERO ZERO_F MBZERO/s
42052 3 61370 0 5.72

Заключаем, что gzip блокирует ресурсный блок, заполняет нулями, а затем копирует содержание. То же самое происходит при загрузке файла на VMFS как из GUI, так и из командной строки.

Автор: Cormac Hogan

пятница, 11 октября 2013 г.

Corrupt дисковой системы. Что делать?

Рассмотрим ситуацию: достоверно известно, что случился corrupt на уровне дисковой системы. Битые сектора или что-то еще - не столь важно. Сверху живет VMFS и виртуальные машины, но в ВМ вроде ничего не случилось, они продолжают работать.
В этой ситуации вполне может быть, что битая область вообще не затрагивает ВМ и все данные остались целыми. Так что же сделать, чтобы свести риски к минимуму?
1. Выключаем затронутые ВМ.
2. Клонируем ВМ на заведомо исправный датастор.
3. Включаем клоны, запускаем проверку целостности файловой системы в каждой ВМ. Можно использовать встроенные средства ОС или использовать любой Rescue CD.
Зачем выключать? При дальнейшей работе, в особенности в случае машин с тонкими дисками и снапшотами, можем затронуть битую область и соотв. ВМ приходит в негодность.
Обратите внимание, что ВМ именно клонируем, а не перемещаем. И тем более не делаем Storage vMotion, иначе есть риск остаться наедине с резервной копией. В случае если она вообще есть.

суббота, 27 апреля 2013 г.

Как заставить ESXi5 видеть диск как SSD datastore

В vSphere 5 представлена новая функция Host Cache, которая позволяет выгрузить своп файл виртуальной машины на выделенный SSD диск для повышения производительности. Для этого на диске, который SATP (Storage Adapter Type Plugin) опознала как твердотельный, создать VMFS раздел, добавить и настроить данное VMFS хранилище для хранения кэша.

Во время тестирования vSphere 5 тестировал самые разнообразные функции, включая Host Caching, но у меня не было доступа к системе с SSD диском во время обновления и создания новых скриптов. После небольшого расследования я узнал, что стандартное правило SATP не опознаёт определённый твердотельный диск, и что можно создать новое правило, содержащее мета информацию о данном конкретном устройстве.

В данном примере я заставлю ESXi 5 думать, что локальный диск mpx.vmhba1:C0:T2:L0 является SSD диском.

Необходимо иметь доступ к esxcli, без разницы через локальную оболочку ESXi, vMA или PowerCLI.

Для выполнения дальнейших шагов диск, который будет представлен как твердотельный, уже должен быть форматирован в VMFS.

Для начала необходимо создать новое SATP правило, в котором будет указан диск, и enable_ssd как опция параметра option.

esxcli storage nmp satp rule add --satp VMW_SATP_LOCAL --device mpx.vmhba1:C0:T2:L0 --option=enable_ssd

Проверить правильность создания можно с помощью листинга всех правил

esxcli storage nmp satp rule list | grep enable_ssd

VMW_SATP_LOCAL       mpx.vmhba1:C0:T2:L0  enable_ssd                  user

Теперь необходимо перерегистрировать диск в системе, чтобы применить к нему новое правило.

esxcli storage core claiming reclaim -d mpx.vmhba1:C0:T2:L0

Теперь вы можете проверить что диск опознан системой как твердотельный, отобразив все детали по данному устройству.

esxcli storage core device list --device=mpx.vmhba1:C0:T2:L0

mpx.vmhba1:C0:T2:L0
   Display Name: Local VMware Disk (mpx.vmhba1:C0:T2:L0)
   Has Settable Display Name: false
   Size: 5120
   Device Type: Direct-Access
   Multipath Plugin: NMP
   Devfs Path: /vmfs/devices/disks/mpx.vmhba1:C0:T2:L0
   Vendor: VMware
   Model: Virtual disk
   Revision: 1.0
   SCSI Level: 2
   Is Pseudo: false
   Status: on
   Is RDM Capable: false
   Is Local: true
   Is Removable: false
   Is SSD: true
   Is Offline: false
   Is Perennially Reserved: false
   Thin Provisioning Status: unknown
   Attached Filters:
   VAAI Status: unsupported
   Other UIDs: vml.0000000000766d686261313a323a30

Теперь параметр Is SSD имеет значение true.

Вы можете обновить Storage view в vSphere Client или через командную строку командой vim-cmd hostsvc/storage/refresh.

Теперь в vSphere Client в разделе Host Cache Configuration появится новый твердотельный диск, который необходимо добавить для использования Host Cache.

Официально это, конечно же, не поддерживается.


Оригинал: http://www.virtuallyghetto.com/

пятница, 21 декабря 2012 г.

Изменение размера диска ВМ

Одна из частых задач для администратора виртуальной платформы - изменение размера диска ВМ.
Вопрос: Зачем это вообще нужно, и почему нельзя создавать ВМ сразу с нужным диском?
Ответ: шаблоны. У меня лично, например, был шаблон с мааааленьким диском (8ГБ) и установленной Windows 2003, который после развертывания нужно было увеличивать под задачу.
Ну диск-то ладно, увеличить просто. А что делать с системным разделом Windows? Дополнительный софт, зачастую платный, перезагрузки и т.д.

Между тем есть магическая утилита от Dell - ExtPart, позволяющая за буквально 30 секунд без перезагрузок увеличить размер диска C: до нужного, если соотв. vmdk уже увеличен.

пятница, 14 декабря 2012 г.

vSphere 5.1 vs Hyper-V R3. Интеграция с СХД.

Во второй части коснёмся темы работы и интеграции с системами хранения данных. В силу того, что в данной статье рассматривается множество функций, то вместо прямого сравнения двух продуктов их возможности будут описываться в каждом разделе.

Поддержка SAN 
Обе системы поддерживают основные блочные протоколы доступа - FC, iSCSI, FCoE, тогда как на файловом уровне Hyper-V использует SMB, а vSphere - NFS. Я бы сказал, что это полный паритет.

Do it yourself (DIY) или дешёвые СХД
Системы хранения данных обычно являются самым дорогим компонентом, поэтому некоторые предпочитают собрать самим более дешёвое решение.

VMware предлагает Virtual Storage Appliance (VSA), работающий как ВМ на хосте и использующий локальные диски для создания отказоустойчивого решения.

Hyper-V предлагает встроенную поддержку iSCSI таргета и SMB шары.

Кроме того, существуют сторонние решения для обоих решений типа LeftHand VSA, Datacore, StarWind и т.д.

Выгрузка операций на массив
Некоторые операции гораздо выгоднее выполнять на самом массиве, а не на хосте - например, клонирование ВМ или перемещение на другой LUN.

На данный момент VMware VAAI, в отличие от Hyper-V ODX, может использовать данные примитивы для клонирования ВМ, а также поддерживается более широким количеством производителей.

Уровень обслуживания
В случае если на хосте запущены критически важные ВМ, им необходимо гарантировать определённый уровень доступных ресурсов, по сравнению с другими ВМ.

vSphere в данном случае предлагает два механизма:

SIOC (Storage IO Control) - аналог QoS для СХД. Пока задержки не достигнут критического уровня все ВМ потребляют необходимое им количество ресурсов, в случае выхода за критическую отметку - ВМ с большим приоритетом получают большую полосу пропускания.

Storage DRS - данный механизм по необходимости перемещает ВМ между датасторами в автоматическом режиме для оптимизации нагрузки.

Hyper-V таких возможностей не имеет. Единственный возможный вариант - использование QoS в конвергентных сетях, что не является полный аналогом функций vSphere так как не позволяет настраивать уровень обслуживания для каждой отдельной машины.

Максимальный размер виртуального диска поддержка дисков с размером блока 4k
Для vSphere максимальный размер диска составляет 2ТБ-512байт, тогда как Hyper-V поддерживает два формата - VHD и VHDX. Последний ограничен размером в 64ТБ.

Также на данный момент vSphere, в отличие от Hyper-V, не поддерживает Advanced Format и диски с размером сектора в 4кб.

Репликация 
Обе платформы имеют встроенные механизмы репликации данных, работающие независимо от подлежащей СХД.

Управление и автоматизация работы с СХД
Virtual Machine Manager использует протокол SMI-S для интеграции с массивами, как следствие операции проводимые с СХД ограничены возможностями данного протокола.

vCenter также поддерживает данный протокол, но все операции с СХД выполняются с помощью специальных плагинов, разрабатываемых поставщиком массива, поэтому функции данных плагинов не ограничены каким-либо протоколом.

Кэширование для VDI
Boot storm - понятие описывающее резкую пиковую загрузку на СХД из-за массовых логинов пользователей утром при приходе на работу. Для снижения нагрузки на СХД используются алгоритмы интеллектуального кэширования данных.

Данная технология есть у обоих продуктов - CBRC (Content Based Reading Cache) у vSphere и CSV Cache у Hyper-V.

Оригинал: http://up2v.nl/

среда, 7 ноября 2012 г.

Storage DRS и альтернативное хранилище своп файлов

По умолчанию своп файлы хранятся в папке с самой ВМ, однако DRS кластер также позволяет указать специальный датастор для хранения свопа. Меня спросили можно ли создать кластер датасторов исключительно для своп файлов. Хотя есть возможность использования одного датастора внутри кластера именно для хранения своп файлов, Storage DRS не будет инициировать балансировку своп файлов по следующей причине.

Альтернативное расположение своп файлов

Таким хранилищем может быть как общедоступное хранилище, так и локальные диски сервера. Хочу отметить, что второй вариант влияет на производительность vMotion из-за необходимости копирования своп файла на целевой датастор конечного хоста. Вместе с тем, может использоваться небольшой датастор, доступный всем хостам в DRS кластере. В таком случае имеет смысл использовать небольшой пул SSD дисков, что позволит уменьшить влияние падение производительности ВМ из-за свопа памяти на диск в случае нехватки физической памяти на сервере.

воскресенье, 23 сентября 2012 г.

Изменения обработки отказов СХД в vSphere 5.1

В vSphere были добавлены два типа отказов СХД, обрабатываемых гипервизором – APD (All Paths Down) в случае выхода временного пропадания всех путей до LUN, и PDL (Permanent Device Lost) – когда LUN считается потерянным безвозвратно.

С версии 5.0 гипервизор научился отличать PDL от APD, так как в первом случае СХД отправляет инициатору соответствующие SCSI команды о том, что LUN удалён и данные с него соотв. недоступны. Таким образом, vmkernel знает, что IO запросы к данному LUN можно сразу отбрасывать, а не ждать ответа (что в конечном итоге могло привести к зависанию корневого процесса hostd).

В vSphere 5.1 представлены новые параметры для управления поведением гипервизора при потере доступа к хранилищу данных. Опция Misc.APDHandlingEnable указывает механизм обработки какой версии 5.0 (0) или 5.1 (1) необходимо использовать, и количество попыток передачи IO к массиву.

В случае использования нового механизма операции ввода-вывода будут отбрасываться со статусом NO_CONNECT через 140 секунд после того как ESXi обнаружит что массив не доступен. Изменять этот таймаут позволяет опция Misc.APDTimeout. Как только один из путей к массиву будет восстановлен – ESXi продолжит передавать данные.

Некоторые массивы используют схему 1 target – 1 LUN. Если на таком массиве удалить LUN, то массив не будет возвращать SCSI команды о том, что LUN не доступен. С версии 5.1 гипервизор способен проанализировать ответ массива и определить, что СХД сбрасывает попытки подключения именно по причине недоступности целевого target, после чего присваивает ему состояние PDL и прекращает попытки подключения.

вторник, 4 сентября 2012 г.

Анонсы с VMworld 2012: vVol, vSAN, vFlash

На недавно прошедшей в Сан-Франциско конференции VMWorld были анонсированы интересные технологии в области работы с СХД, точнее с vStorage, которые VMware собирается представить в ближайшее время: Virtual Volumes (vVols), Virtual SAN (vSAN) и Virtual Flash (vFlash?). Итак, что это за названия и в каком направлении движется VMware?

Virtual Volumes или vVols

Принципы работы с SAN и NAS массивами были заложены десятки лет назад: взять кучу дисков, равномерно распределить данные между ними во избежание возможных проблем при выходе одного из дисков из строя, объединить их логические единицы и предоставить серверам. Сегодня принцип практически тот же: у вас есть LUN или «шара», куда сохраняются виртуальные диски.


Задайте себе вопрос: оптимальное ли это решение? Что если вы хотите реплицировать ВМ? Тогда вам нужно реплицировать весь LUN. Выхода из данной ситуации два: создать LUN достаточный чтобы положить туда нужное количество ВМ и реплицировать их все сразу, или создать под каждую ВМ один LUN и, таким образом, получить требуемую частоту репликации. Оптимального решения нет. Или всё таки есть? Идеально иметь одну точку для подключения всех ВМ, и уйти от идеи с LUN или разграничением доступа (share).

понедельник, 30 июля 2012 г.

Как работает Storage IO Control (SIOC)

В vSphere есть отличная функция Storage IO Control, которая используется для предотвращения захвата всей пропускной способности одной виртуальной машиной или хостом. Для определения момента захвата ресурсов одним источником SIOC мониторит задержки работы СХД, и после определённого порога урезает глубину очереди к массиву.

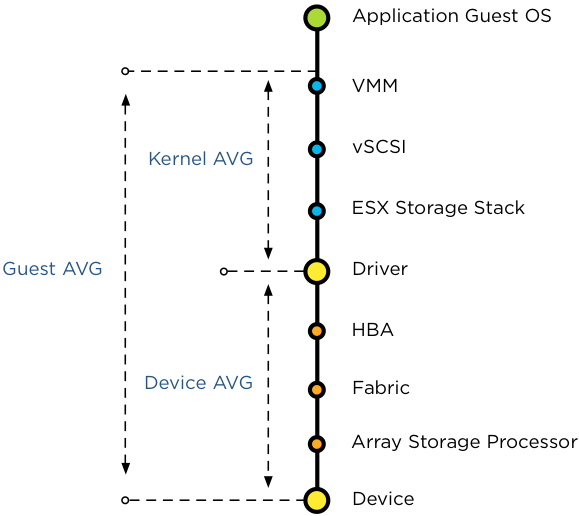
Вопрос в том, какие именно метрики задержек отслеживаются SIOC - среднее время ответа устройства (DAVG), время ответа ядра (KAVG) или задержки ВМ (GAVG)?


На самом деле ни одна из них. Все они являются локальными метриками планировщика ресурсов, которые и отвечает за отправку всех запросов к СХД. Основная же задача SIOC - управлять ресурсами общей СХД между несколькими ESXi хостами, предоставляя IO ресурсы для всех ВМ независимо от того на каком хосте они работают. И так как SIOC должен регулировать и приоритезировать доступ к общему хранилищу нескольких ESXi хостов, локальные метрики хоста игнорируются. Но какие же, в таком случае, используются метрики? По сути, пороговое значение сравнивается со средним значением DAVG на каждом хосте и средним количеством IOPS на хосте.

понедельник, 16 июля 2012 г.

Изменения в обработке отказа СХД в vSphere 5.0 U1

О том какие бывают типа отказа СХД и чем отличает APD от PDL можно прочитать в данной статье.

В vSphere 5.0 НА никак не реагировал на изменения состояние СХД, и если у ВМ пропадал доступ к данным считалось, что так и должно быть, и ВМ продолжит работать или будет перезапущена администратором после решения проблем с СХД.

В vSphere 5.0 U1 был представлен новый механизм, который позволяет менять поведение НА в случае потери доступа (PDL) к массиву. Управлять реакцией НА в можно с помощью двух опций: disk.terminateVMOnPDLDefault, параметры которой редактируются в файле /etc/vmware/settings, и das.maskCleanShutdownEnabled, параметры которой редактируются в расширенных свойствах НА кластера.

VMware рекомендует выставлять параметры обоих опций всегда в True, тогда в случае потери доступа к массиву, виртуальная машина будет выключена в момент обращения к потерянному массиву (за это отвечает первая опция), а при восстановлении доступа к массиву будет перезапущена с помощью НА (за это отвечает вторая опция, которая и позволяет НА отличать какая машина была выключена администратором, а какая была выключена в результате PDL).

Также при наступлении аварийной ситуации в логе vmkernel будут появляться следующие сообщения:

2012-03-14T13:39:25.085Z cpu7:4499)WARNING: VSCSI: 4055: handle 8198(vscsi4:0):opened by wid 4499 (vmm0:fri-iscsi-02) has Permanent Device Loss. Killing world group leader 4491
2012-03-14T13:39:25.085Z cpu7:4499)WARNING: World: vm 4491: 3173: VMMWorld group leader = 4499, members = 1


Оригинал: Duncan Epping

четверг, 3 мая 2012 г.

Использование одного Storage DRS кластера c несколькими DRS кластерами

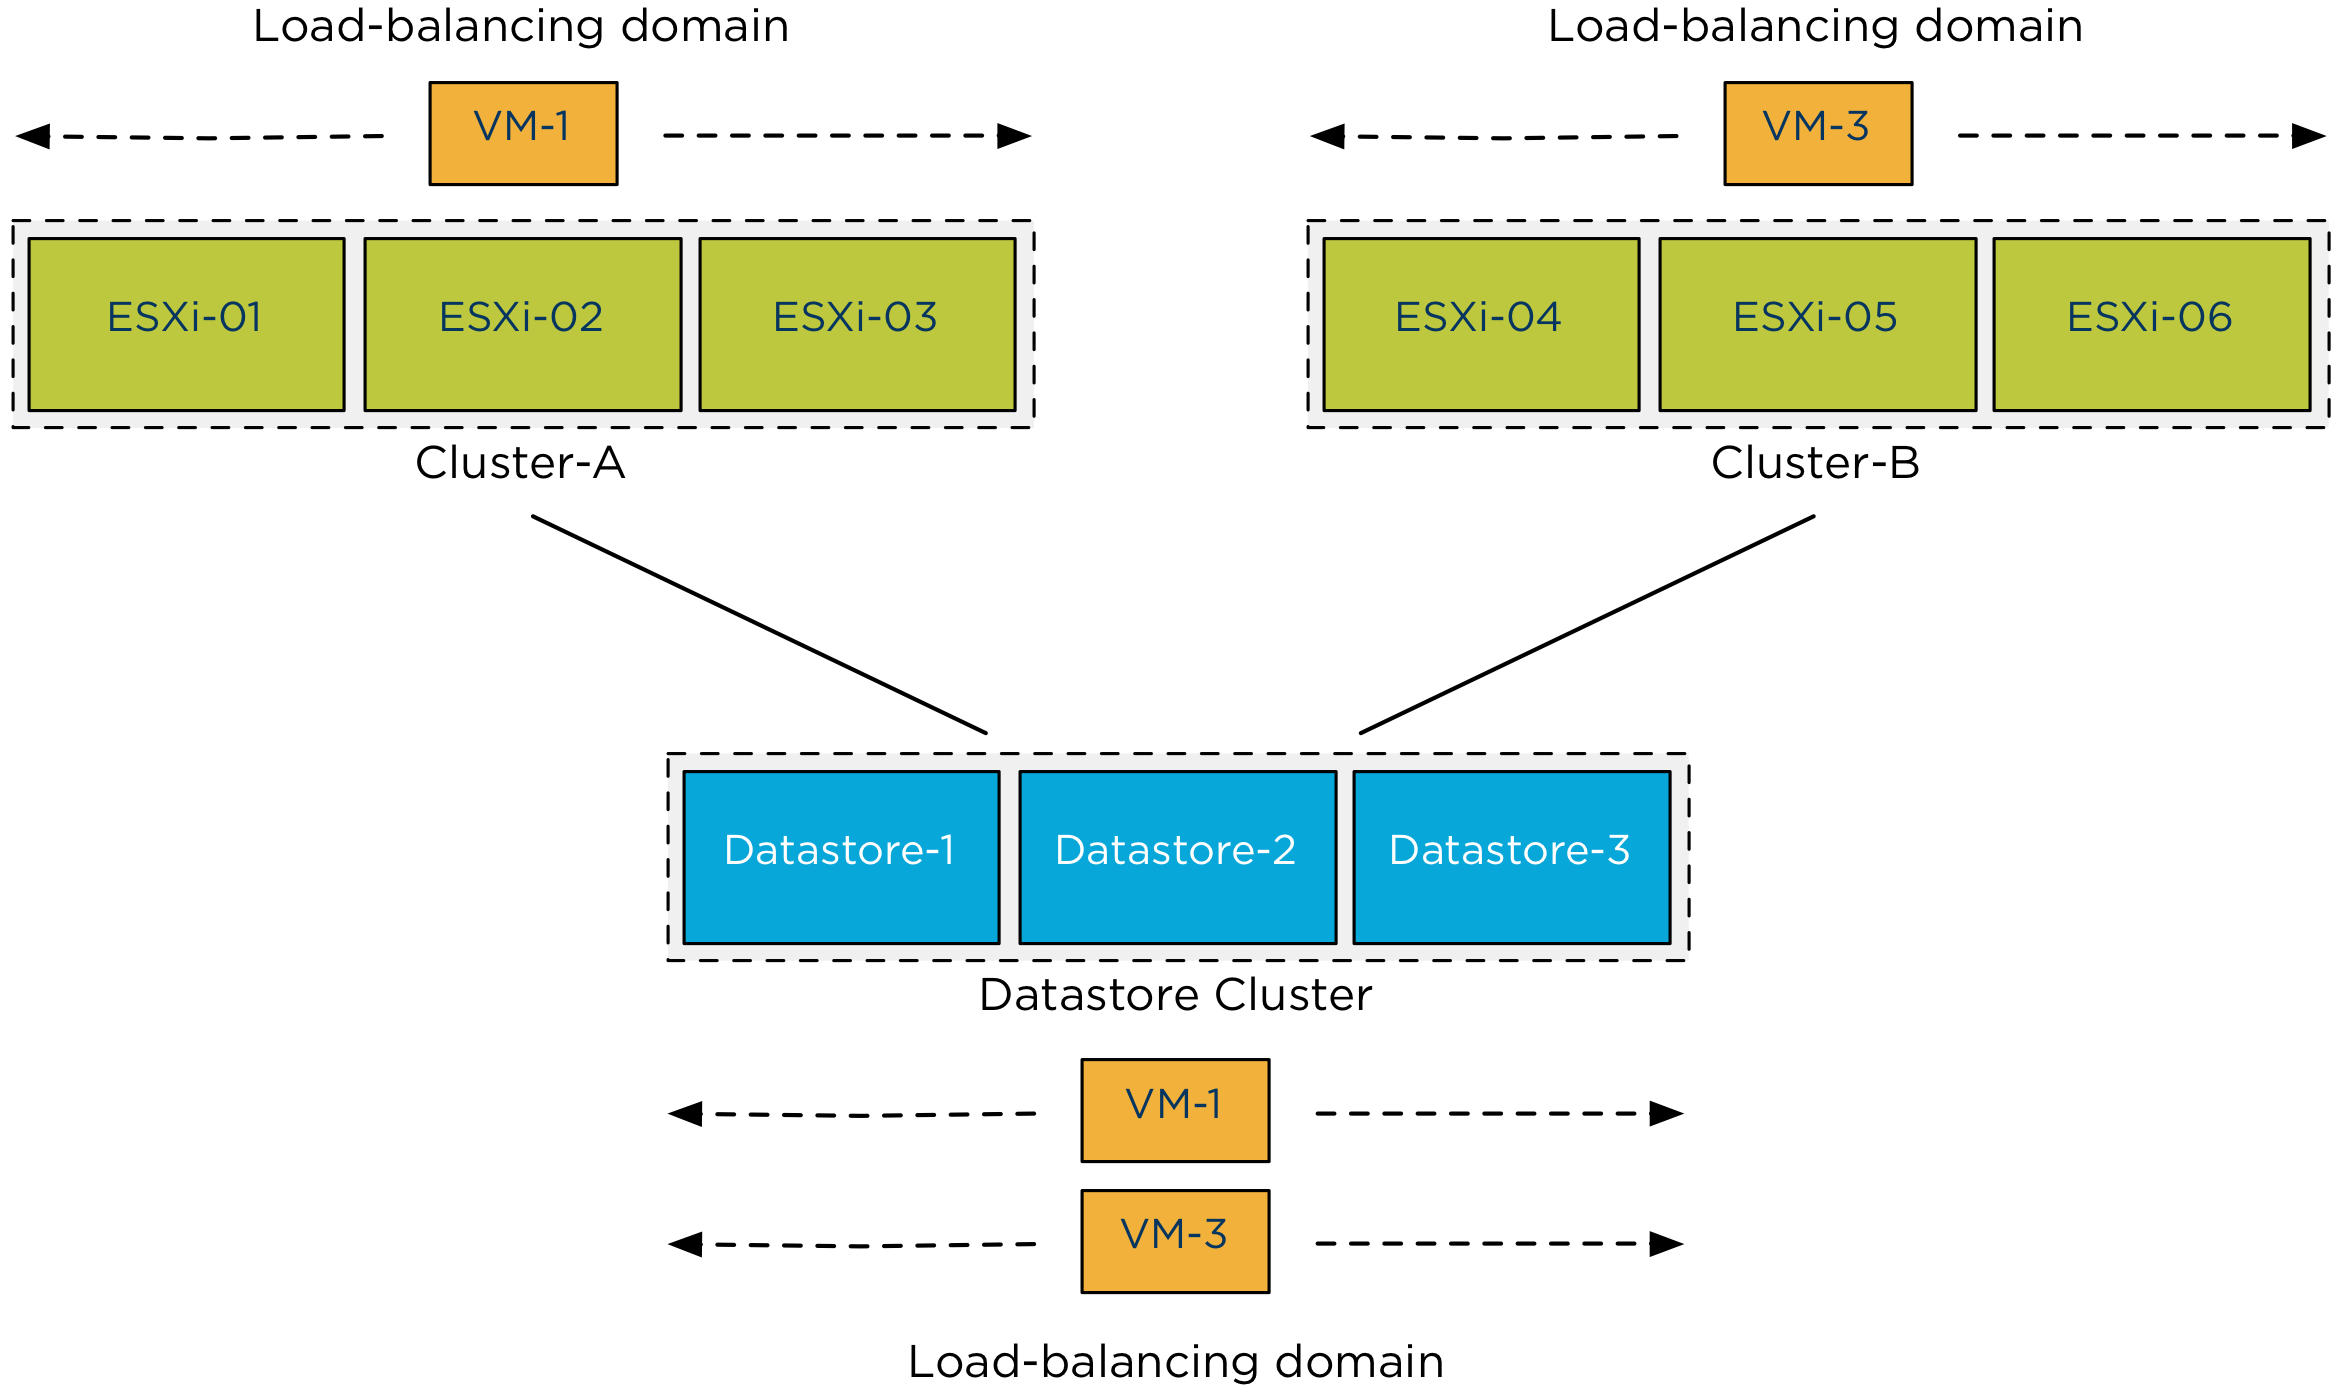
Во-первых, такая конфигурация полностью поддерживается VMware. Во время создания ВМ администратор выбирает в каком DRS кластере будет работать ВМ, а Storage DRS кластер, в свою очередь, сервер который может предоставить наибольшее количество ресурсов для виртуальной машины в данном кластере. Рекомендованные миграции, генерированные Storage DRS, не мигрируют ВМ на уровне физического хоста, так как виртуальная машина не может быть перемещена между DRS кластерами по запросу от Storage DRS кластера.
При таком дизайне также необходимо учитывать максимумы конфигураций: в Storage DRS кластер может входить до 32 датасторов, к одному датастору может быть подключено до 64 хостов одновременно, а максимальное количество LUN подключённых к хосту - 255 или же 1024 пути, при использовании multipathing.

Также рекомендуется использовать СХД с поддержкой VAAI или же включать данную технологию, если она поддерживается, так как один из примитивов - Hardware assisted locking или Test and Set (ATS) заменяет SCSI-2 резервирование, что позволяет значительно увеличить скорость работы. Разница между SCSI-2 резервированием и ATS состоит в том, что первый метод блокирует весь LUN при обновлении метаданных или увеличении размера файла, а второй только требуемые сектора, таким образом, позволяя другим хостам использовать данный LUN не ожидая пока будет снято резервирование. Дополнительную информацию о резервировании вы можете найти в КВ 1021976.

При использовании IO Metric для всех датасторов в кластере автоматически включается SIOC (Storage IO Control). Storage DRS использует IO инжектор SIOC для определения производительности СХД, а SIOC используется для равномерного распределения нагрузки в периоды нехватки ресурсов.

SIOC использует доли (shares) дисков виртуальных машин для распределения ресурсов и работает на уровне всего датастора. Если быть более точным, то SIOC это серверный модуль, который собирает данные о задержках доступа наблюдаемых от сервера к СХД. Если задержки превышают пороговый предел, то все хосты изменяют настройку количества очереди запросов к LUN согласно общему количеству долей виртуальных машин, работающих на данном хосте.

Оригинал: http://frankdenneman.nl/

пятница, 2 марта 2012 г.

Cравнение протоколов доступа к СХД


iSCSI NFS FC FCoE
Описание Протокол блочного уровня.
Все SCSI команды инкапсулируются в TCP/IP пакеты и передаются на СХД
Протокол файлового уровня.
NFS массив предоставляет доступ ESX хосту к своей локальной файловой системе.
ESX хост же обращается к метаданным и файлам используя протокол основанный на RPC.
В данный момент поддерживается NFS v3 поверх TCP/IP
Протокол блочного уровня.
Все SCSI команды инкапсулируются в FC фреймы
Протокол блочного уровня.
Все SCSI команды инкапсулируются в Ethernet фреймы.
Во многом схож с Fibre Channel.
Поддерживается с vSphere 5
Возможности реализации 1. vSphere vmkernel (обычная сетевая карта)
2. Dependent iSCSI Initiator (сетевая карта с функциями SCSI Offload+vmkernel)
3. Independent iSCSI Initiator (отдельный HBA адаптер)
vSphere vmkernel (обычная сетевая карта) Выделенный HBA адаптер.
Для отказоустойчивости и поддержки multipathing требуется минимум 2 адаптера
1. Hardware Converged Network Adapter (CNA)
2. Software FCoE инициатор (требуется сетевая карта с поддержкой FCoE)
Производительность 1. Поддерживается 1Gbit\10Gbit Ethernet.
2. Несколько соединений могут быть объединены в одну сессию.
3. Поддержка Jumbo Frames.
4. Более высокая нагрузка на ЦПУ за счёт инкапсуляции трафика
1. Поддерживается 1Gbit\10Gbit Ethernet.
2. Не смотря на возможность использования UDP, VMware её не поддерживает.
3. Поддержка Jumbo Frames.
4. Более высокая нагрузка на ЦПУ за счёт инкапсуляции трафика
1. Поддерживается 1/2/4/8 и 16Gb HBA, но последние в vSphere 5 должны работать в режиме 8Gb.
2. Buffer-to-Buffer и End-to-End кредиты гарантируют сеть без потери пакетов.
3. Низкая нагрузка на ЦПУ, так как HBA инкапсулирует весь трафик
1. Требует 10Gb Ethernet.
2. Требует поддержки Jumbo Frames (стандартный размер пакета FC – 2.2KB, а не 1.5 как у Ethernet).
3. Меньшая нагрузка на сеть, по сравнению с iSCSI и NFS, так как нету инкапсуляции SCSI в TCP\IP
Балансировка нагрузки VMware Pluggable Storage Architecture (PSA)поддерживает Round-Robin для распределения нагрузки между путями.
Лучше использовать с большим количеством LUN
В данный момент такой возможности не существует, так как используется только одна сессия.
Агрегация каналов может быть достигнута путём подключения по разным путям
VMware Pluggable Storage Architecture (PSA)поддерживает Round-Robin для распределения нагрузки между путями.
Лучше использовать с большим количеством LUN
VMware Pluggable Storage Architecture (PSA)поддерживает Round-Robin для распределения нагрузки между путями.
Лучше использовать с большим количеством LUN
Отказоустойчивость Отказоустойчивость обеспечивается с помощью Storage Array Type Plugin (SATP) для всех поддерживаемых iSCSI массивов NIC Teaming. Хотя данный метод не защищает от сбоев на стороне хранилища Отказоустойчивость обеспечивается с помощью Storage Array Type Plugin (SATP) для всех поддерживаемых FC массивов Отказоустойчивость обеспечивается с помощью Storage Array Type Plugin (SATP) для всех поддерживаемых FCoE массивов
Проверка на наличие ошибок Протокол использует TCP, который пересылает пакеты в случае потери пакетов Протокол использует TCP, который пересылает пакеты в случае потери пакетов FC является сетью с гарантией сохранности данных.
Обеспечивается благодаря Buffer-to-Buffer и End-to-End кредитам и регулированием полосы пропускания в случае нехватки ресурсов
FCoE требует использования сети с гарантией сохранности данных.
Достигается использованием механизма Pause Frame в случае нехватки ресурсов
Безопасность Авторизация, в том числе и двусторонняя, обеспечивается протоколом Challenge Handshake Authentication Protocol (CHAP).
Рекомендуется использовать VLAN или выделенные сети для разделения трафика
Рекомендуется использовать VLAN или выделенные сети для разделения трафика Некоторые свитчи поддерживают VSAN, являющуюся аналогом VLAN.
Также рекомендуется использовать зонинг между массивов и хостами
 Некоторые свитчи поддерживают VSAN, являющуюся аналогом VLAN.
Также рекомендуется использовать зонинг между массивов и хостами
Поддержка Virtual API for Array Integration Поддержка определённых примитивов зависит от производителя. Всего доступны следующие примитивы: Atomic Test/Set, Full Copy, Block Zero, Thin Provisioning, Unmap.
Все они интегрированы в ESXi и не требуют установки дополнительных элементов
Поддержка определённых примитивов зависит от производителя. Всего доступны следующие примитивы:Full Copy (не поддерживается для Storage vMotion, только для холодной миграции), Write Zeros, Clone Offload.
Требуется плагин для ESXi от производителя массива
Поддержка определённых примитивов зависит от производителя. Всего доступны следующие примитивы: Atomic Test/Set, Full Copy, Block Zero, Thin Provisioning, Unmap. Все они интегрированы в ESXi и не требуют установки дополнительных элементов Поддержка определённых примитивов зависит от производителя. Всего доступны следующие примитивы: Atomic Test/Set, Full Copy, Block Zero, Thin Provisioning, Unmap. Все они интегрированы в ESXi и не требуют установки дополнительных элементов
Загрузка ESXi с СХД Да Нет Да Да для CNA, нет для software initiator
Поддержка Raw Device Mapping Да Нет Да Да
Максимальный размер datastore 64ТБ Зависит от производителя массива 64ТБ 64ТБ
Максимальное количество устройств 256 по умолчанию 8, максимально 256 256 256
Прямое подключение СХД в ВМ Да, с помощью инициатора в ВМ Да, с помощью клиента в ВМ Нет, но FC устройства могут быть подключены к ВМ с помощью NPIV. Требует предварительного подключения RDM и поддержки NPIV со стороны оборудования Нет
Поддержка Storage vMotion Да Да Да Да
Поддержка Storage DRS Да Да Да Да
Поддержка Storage I/O Control Да, с vSphere 4.1 Да, с vSphere 5.0 Да, с vSphere 4.1 Да, с vSphere 5.0
Поддержка MSCS в ВМ VMware не поддерживает такую конфигурацию, если ВМ хранятся на iSCSI массиве. Если iSCSI LUN подключён напрямую в ВМ, то такая конфигурация поддерживается Microsoft. Нет Да Нет
Сложность настройки Средняя. Необходимо знать FQDN или IP адрес массива. Может быть необходима настройка подключений инициатора со стороны массива. Сразу после обнаружения LUN доступен для форматирования под VMFS или подключения как RDM Низкая. Необходимо знать FQDN или IP адрес массива и точка монтирования. Сразу после обнаружения массив доступен для работы Высокая. Включает в себя зонирование со стороны свитча и маскирование LUN со стороны хоста. Сразу после обнаружения LUN доступен для форматирования под VMFS или подключения как RDM Высокая. Включает в себя зонирование со стороны свитча и маскирование LUN со стороны хоста. Сразу после обнаружения LUN доступен для форматирования под VMFS или подключения как RDM
Преимущества Не требует использования дополнительного оборудования, можно построить используя существующие ресурсы. Хорошо известный и зрелый протокол. Администраторы с небольшими знаниями о сетях смогут без проблем подключить массив. Проблемы решаются использованием стандартных инструментов типа Wireshark Не требует использования дополнительного оборудования, можно построить используя существующие ресурсы. Хорошо известный и зрелый протокол. Администраторы с небольшими знаниями о сетях смогут без проблем подключить массив. Проблемы решаются использованием стандартных инструментов типа Wireshark Хорошо известный и зрелый протокол. Используется в большинстве критически важных инфраструктур Позволяет строить конвергированные сети, консолидируя трафик разных в одной сети, используя CNA. Благодаря использованию протокола DCB (Data Center Bridging ) FCoE является протоколом без потери пакетов не смотря на то, что работает поверх Ethernet.
Недостатки Невозможность маршрутизации при использовании iSCSI Binding.
Возможны проблемы с безопасностью из-за отсутствия встроенных механизмов шифрования, необходимость использовать VLAN.
Software iSCSI инициатор повышает нагрузку на ЦПУ.
TCP повышает задержки
Так как используется только одна сессия на подключение, настройка при использовании multipathing требует аккуратности и внимания. Нету PSA multipathing. Возможны проблемы с безопасностью из-за отсутствия встроенных механизмов шифрования, необходимость использовать VLAN.
VMware все еще использует NFS v3, хотя доступны v4 и v4.1.
NFS повышает нагрузку на ЦПУ.
TCP повышает задержки
Не поддерживается FC 16Gb. Необходимо дополнительное оборудование - свитчи, HBA и т.д. Сложность в поддержке.
Сложность в решении проблем.
Новый протокол, и не такой зрелый, как остальные.
Требует lossless 10Gb Ethernet.
Для маршрутизации используются не механизмы IP, а свой протокол - FIP (FCoE Initialization Protocol). Возможны сложности в решении проблемы из-за использования одного канала для всех видов трафика

В таблицу специально не включён протокол AoE (ATA over Ethernet) из-за своей непопулярности и небольшого количества реализаций.  

среда, 11 января 2012 г.

Обработка отказа СХД в vSphere 5

К сожалению, бывают случаи, когда vSphere теряет доступ к системе хранения данных по той или иной причине. В vSphere 4 отказ доступа к СХД мог привести к непредсказуемому результату: от немедленного BSoD у высоконагруженных ВМ до нормальной работы у простаивающих серверов за счёт работы с локальным кэшем. В vSphere 5 обработка отказов СХД была существенно переработана и улучшена.
vSphere 5 теперь различает два состояния отказа LUN: отказ всех путей (APD – All Paths Down) и перманентный отказ устройства (PDL – Permanent Device Lost). Разница между APD и PDL видна в названии – в первом случае система временно не имеет доступа к LUN (например, вышел из строя свитч к СХД), тогда как во втором случае LUN был удалён из СХД.

С технической стороны разница состоит в SCSI кодах, получаемых vmkernel при попытке обращения к LUN. Детальное описание всех кодов и сообщений в логах доступно в этой статье VMware KB.

Данные о APD/PDL никак не передаются виртуальной машине, и обрабатываются на уровне гипервизора, так что если в случае APD/PDL не записанные из-за истечения тайм-аута данные будут сброшены, виртуальная машина попытается снова записать их на диск.
Гипервизор же в случае отказа всех путей к LUN будет хранить данные в кэше vmkernel вплоть до восстановления доступа к устройству, тогда как в случае с перманентным отказом устройства данные даже не будут кэшироваться, чтобы избежать ситуаций с переполнением буфера процесса hostd, что приводило к неотзывчивости системы в vSphere 4.

Нюанс обработки удаления LUN в некоторых СХД

Некоторые низкоуровневые СХД не поддерживают технологию multi LUN, и используют схему 1 LUN – 1 таргет. Если такой LUN удалить из СХД, то при обращении в ответ не будут высланы соответствующие SCSI коды и vSphere не сможет понять, что LUN удалён навсегда (PDL), а будет считать, что это временный отказ путей к хранилищу (APD).