понедельник, 30 июля 2012 г.

Как работает Storage IO Control (SIOC)

В vSphere есть отличная функция Storage IO Control, которая используется для предотвращения захвата всей пропускной способности одной виртуальной машиной или хостом. Для определения момента захвата ресурсов одним источником SIOC мониторит задержки работы СХД, и после определённого порога урезает глубину очереди к массиву.

Вопрос в том, какие именно метрики задержек отслеживаются SIOC - среднее время ответа устройства (DAVG), время ответа ядра (KAVG) или задержки ВМ (GAVG)?
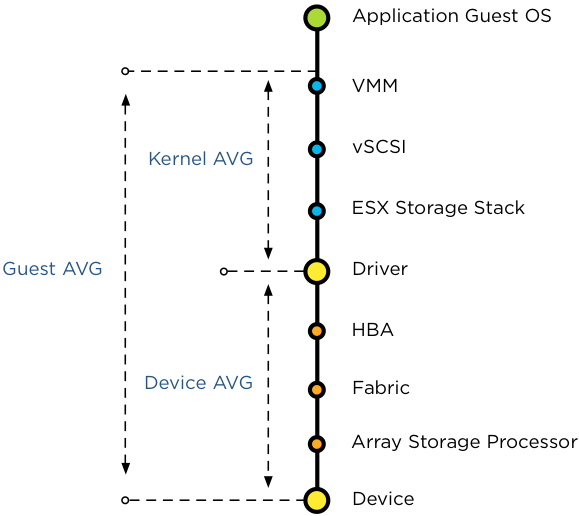

На самом деле ни одна из них. Все они являются локальными метриками планировщика ресурсов, которые и отвечает за отправку всех запросов к СХД. Основная же задача SIOC - управлять ресурсами общей СХД между несколькими ESXi хостами, предоставляя IO ресурсы для всех ВМ независимо от того на каком хосте они работают. И так как SIOC должен регулировать и приоритезировать доступ к общему хранилищу нескольких ESXi хостов, локальные метрики хоста игнорируются. Но какие же, в таком случае, используются метрики? По сути, пороговое значение сравнивается со средним значением DAVG на каждом хосте и средним количеством IOPS на хосте.

понедельник, 16 июля 2012 г.

vSphere Admission Control

Когда мы говорим про контроль доступа, или же admission control, мы обычно имеем в виду политики HA, хотя это не единственная функция, использующая контроль доступа. DRS, Storage DRS, да и сами ESXi хосты имеют свой собственный механизм контроля доступа. Предлагаю детально взглянуть на то, чем же является механизм контроля доступа, и какое участие он принимает в запуске виртуальной машины.

Какова же основная функция контроля доступа? Мне нравится называть эту функцию командой виртуальных балансировщиков. Admission control разработан, чтобы гарантировать предоставление виртуальной машине требуемое и настроенное количество ресурсов. Последняя часть предыдущей фразы и объясняет суть контроля доступа.

Параметры DRS кластера MinGoodness и CostBenefit

В VMware KB есть статья о настройке таких параметров DRS кластера как MinGoodness и CostBenefit. Обычно после перезагрузки хоста или перевода его в/из режима поддержки DRS ещё какое-то время не перемещает на него ВМ, и сервер работает вхолостую. С помощью данных параметров эту опцию можно выключить, а также заставить DRS более агрессивно мигрировать ВМ между хостами. Вместе с тем, эти параметры были сделаны тоже не просто так, и я не рекомендую изменять эти параметры, и вот почему.

Задачи балансировки нагрузки DRS
Главная задача DRS это предоставление виртуальным машинам требуемые ресурсы. Если ВМ получает ресурсы, которые она запрашивает (динамическое выделение ресурсов), то нет необходимости искать для неё лучший сервер. Если же ВМ не получает ресурсы, доступные ей в рамках динамического выделения, то DRS будет рассматривать возможность её перемещения, принимая во внимание дополнительные факторы.

Изменения в обработке отказа СХД в vSphere 5.0 U1

О том какие бывают типа отказа СХД и чем отличает APD от PDL можно прочитать в данной статье.

В vSphere 5.0 НА никак не реагировал на изменения состояние СХД, и если у ВМ пропадал доступ к данным считалось, что так и должно быть, и ВМ продолжит работать или будет перезапущена администратором после решения проблем с СХД.

В vSphere 5.0 U1 был представлен новый механизм, который позволяет менять поведение НА в случае потери доступа (PDL) к массиву. Управлять реакцией НА в можно с помощью двух опций: disk.terminateVMOnPDLDefault, параметры которой редактируются в файле /etc/vmware/settings, и das.maskCleanShutdownEnabled, параметры которой редактируются в расширенных свойствах НА кластера.

VMware рекомендует выставлять параметры обоих опций всегда в True, тогда в случае потери доступа к массиву, виртуальная машина будет выключена в момент обращения к потерянному массиву (за это отвечает первая опция), а при восстановлении доступа к массиву будет перезапущена с помощью НА (за это отвечает вторая опция, которая и позволяет НА отличать какая машина была выключена администратором, а какая была выключена в результате PDL).

Также при наступлении аварийной ситуации в логе vmkernel будут появляться следующие сообщения:

2012-03-14T13:39:25.085Z cpu7:4499)WARNING: VSCSI: 4055: handle 8198(vscsi4:0):opened by wid 4499 (vmm0:fri-iscsi-02) has Permanent Device Loss. Killing world group leader 4491
2012-03-14T13:39:25.085Z cpu7:4499)WARNING: World: vm 4491: 3173: VMMWorld group leader = 4499, members = 1


Оригинал: Duncan Epping

четверг, 7 июня 2012 г.

Я знаю отличную шутку про...

1. Я знаю отличную шутку про UDP, но не факт, что она до вас дойдет.
2. Я знаю отличную шутку про TCP, но если она до вас не дойдет, то я повторю.

3. А кто знает отличную шутку про ARP?
4. А вы слышали шутку про ICMP?
5. Вам еще кто-то рассказывал шутку про STP?
6. Я подожду Антона и расскажу классную шутку про QoS.
7. Про MTU тоже есть кла
8. <шутка><смешная/><про>XML</про></шутка>
9. А про FSMO роли шутить могут не более пяти человек.
10. Подождите все, я расскажу шутку о сети типа "шина".
11. Я бы рассказал отличную шутку про Token Ring, но сейчас не моя очередь.
12. Стой-стой, послушай сначала шутку о прерываниях.
13. Помню времена, когда шутка про модем пшшшшшшш.....
14. Только что, специально для сообщества пришла шутка про мультикаст.
15. Жаль, что шутка про Fault Tolerance не может состоять больше, чем из одного слова.
16. Настало время рассказать шутку про NTP.
17. Я сейчас расскажу отличную шутку про VPN, но ее поймет только один.
18. К шутке про SCTP вначале должны все подготовиться.
19. Из-за одного, кто зевнул, придётся заново рассказывать шутку про frame relay в топологии point-to-multipoint.
20. А шутки про HDLC обычно не понимают те, кто знает другие шутки про HDLC.
21. Про DWDM шутят сразу несколькими голосами.
22. Шутка про Е3 - это 30 одинаковых шуток про Е1 и еще две шутки, понятных только тем, кто в теме.

пятница, 4 мая 2012 г.

Облака и RCCPA

Мы сделали это!

В России создана Russian Cloud Computing Professional Association (RCCPA) – первое профессиональное объединение независимых экспертов, работающих в области создания, развития и внедрения «облачных» технологий и сервисов. Ассоциация создана в марте 2012 года группой активистов «облачного» рынка. Наши основные цели - выработка единых подходов к формированию развития «облачных» вычислений в России и формирование экспертной площадки для развития российских “облачных” проектов на международных рынках. В планах ассоциации – регулярное проведение встреч, семинаров и конференций, в рамках которых члены ассоциации смогут обмениваться опытом по профильным вопросам.  Мы открыты для сотрудничества, членство и участие в мероприятиях ассоциации бесплатно.

Ждем вас в ассоциации - специалистов по дизайну виртуализованных инфраструктур, превращению железа в облако и продажам облачных услуг. Приходите на CloudConf 2012, где мы будем вручать первую в России премию за достижения в облачных вычислениях - Cloud Award 2012. Ну а я буду участвовать в зажигательном круглом столе "Облачная жесть как она есть" и рассказывать об особенностях облачного хранения данных.

А в этом блоге появляется новая тематика: облака :)

И в качестве начала новых, облачных дискуссий, предлагаю вашему вниманию перевод стандарта NIST по облачным вычислениям. Замечания и критика приветствуются!

четверг, 3 мая 2012 г.

Что лучше: Etherchannel и IP Hash или Load Based Teaming?

Споры что лучше - Etherchannel или LBT ведутся с тех пор, как последний механизм балансировки нагрузки появился в vSphere 4.1. Основная причина споров состоит в том, что администраторы или не знают о существовании LBT, или же думают, что сетевой стек у vSphere работает как и у физических серверов - один интерфейс активен, а все остальные простаивают до момент выхода активного из строя.

Варианты тиминга сетевых интерфейсов в vSphere

С самого начала хочу отметить, что vNetwork Distributed Switch (vDS) поддерживает пять разных режимов тиминга, но не поддерживает  LACP (802.3ad) или же Dynamic Etherchannel, поддерживается только Static Etherchannel. Для использования LACP необходимо использовать Cisco Nexus 1000V или какой-либо другой сторонний vDS.

Итак, vSphere поддерживает следующие режимы работы: