Продолжаю публикацию всего, что относится к HA :)
В документе vCenter Performance Best Practices появилось упоминание о двух новых расширенных параметрах HA.
das.perHostConcurrentFailoversLimit
Одновременно при наступлении HA-события может быть перезапущено до 32 ВМ на одном хосте (по умолчанию). Число 32 выбрано, чтобы избежать перегрузки хоста при битве ВМ за ресурсы. При помощи данного параметра можно изменить количество одновременных рестартов и сократить общее время восстановления, однако это может привести к росту среднего времени восстановления ВМ. Рекомендуется использовать значение по умолчанию.
das.sensorPollingFreq
Этот параметр управляет интервалом опроса. HA опрашивает систему для обновления общей информации о кластере (сколько ВМ запущено и т.д.) В vSphere 4.0 установлен интервал 1 секунда, в vSphere 4.1 - 10 секунд. Меньшее значение дает более быстрый перезапуск ВМ, а большее - эластичность кластера, если требуется массовое включение ВМ в большом кластере. Может принимать значения от 1 до 30 секунд.
Источник: Duncan Epping (www.yellow-bricks.com)
вторник, 24 августа 2010 г.


понедельник, 16 августа 2010 г.
vSphere PowerCLI: урок 5
Если посмотреть на урок 3, мы говорили о команде, которая выводит список всех Get- командлетов PowerCLI:
Но Get- не единственный глагол используемый в PowerShell, вы также найдете:
>gcm –Module vmware* -verb getДля командлетов PowerShell принята система названия Verb-MeaningfulWord (Глагол-ЗначимоеСлово), например Get-VM.
Но Get- не единственный глагол используемый в PowerShell, вы также найдете:
- Set-
- New-
- Add- (таких только 3 в PowerCLI)
пятница, 13 августа 2010 г.
Грабли: Veeam со странными ошибками при работе с vSphere 4.1
Проблемы c Veeam Backup & Replication после апгрейда до vSphere 4.1:
1) При репликации ВМ возникают постоянные ошибки "Create virtual disk. The requested operation is not implemented by the server", а так же ошибки с удалением файлов - файлы удаляются только с 4го раза.
2) При репликации внезапно перестает видеть replica.vbk, хотя файл в директории присутствует.
Лечение: апгрейд до последней версии Veeam Backup & Replication 4.1.2
четверг, 5 августа 2010 г.
Отказоустойчивое хранилище для vSphere на базе StarWind iSCSI
Ранее я уже писал о том, как сделать дешевое разделяемое хранилище для vSphere на базе Linux. Но что если вы хотите избавиться от единой точки отказа и сделать разделяемое хранилище отказоустойчивым? Можно поднять второй узел с Linux и прикручивать различные пакеты для отказоустойчивости, как например drbd и heartbeat. А можно обратить внимание на коммерческую разработку компании StarWind, и получить решение Enterprise класса.
Кстати, в марте при помощи StarWind iSCSI SAN был поставлен рекорд в 1 000 000 (!) IOPS.
StarWind iSCSI имеет функцию отказоустойчивости, сетевой зеркальный диск, уже давно. Но в этой конфигурации все работает только с главным узлом, и если с ним что-то случится, то простой и переключение вручную неизбежны.
Чтобы такого не случалось, появилась функция HA - непрерывная синхронная репликация данных между узлами и поддержка multipathing.
Итак, вы скачали StarWind iSCSI и что теперь с ним делать? Я расскажу.
четверг, 29 июля 2010 г.
Грабли: апгрейд VMware Tools не проходит
Проблема:
1. "Правый клик / Guest / Install/Upgrade VMware Tools / Automated" практически сразу выдает ошибку "Error upgrading VMware Tools"
2. При апгрейде через интерфейс VMware Tools в гостевой Windows (кнопка "Upgrade") ничего не происходит.
3. Апгрейд в интерактивном режиме проходит нормально.
Существует статья в KB: Upgrading VMware Tools may fail when using Automatic Tools Upgrade in the vSphere Client
Решение: удалить VMwareToolsUpgrader.exe из %Temp% (обычно C:\Windows\Temp) и перезапустить апгрейд.
Алексей Тараненко любезно помог с PowerShell скриптом для автоматизации процесса.
понедельник, 26 июля 2010 г.
HA/DRS и нормализованные Shares
Неделю назад я уже упомянул о важном нововведении в vSphere 4.1, нормализованных shares.
Что же это такое?
При failover'е HA помещает ВМ в корневой ресурс-пул, и если при этом ВМ сама находилась в ресурс-пуле и имела высокое значение shares, то она будет иметь то же самое значение shares и после failover'а.
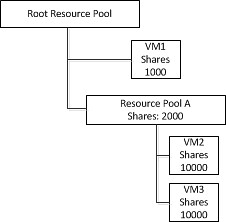
Предположим, что у нас есть 3 ВМ, 2 из которых находятся в специальном ресурс-пуле Resource Pool A. У VM1 1000 shares, у Resource Pool A - 2000. При этом в ресурс пуле находятся еще 2 ВМ, каждая из которых имеет по 10000 shares. Напомню, что shares в данном случае действуют только в пределах ресурс-пула, и обе ВМ имеют соотв. по 50%. Т.е. VM1 имеет 33% ресурсов, VM2 и VM3 по 50% от 66% ресурс-пула -> все три ВМ имеют по 33% ресурсов.
Что же это такое?
При failover'е HA помещает ВМ в корневой ресурс-пул, и если при этом ВМ сама находилась в ресурс-пуле и имела высокое значение shares, то она будет иметь то же самое значение shares и после failover'а.
Предположим, что у нас есть 3 ВМ, 2 из которых находятся в специальном ресурс-пуле Resource Pool A. У VM1 1000 shares, у Resource Pool A - 2000. При этом в ресурс пуле находятся еще 2 ВМ, каждая из которых имеет по 10000 shares. Напомню, что shares в данном случае действуют только в пределах ресурс-пула, и обе ВМ имеют соотв. по 50%. Т.е. VM1 имеет 33% ресурсов, VM2 и VM3 по 50% от 66% ресурс-пула -> все три ВМ имеют по 33% ресурсов.
пятница, 23 июля 2010 г.
2 года в эфире
Вот так в летнем угаре 2010 года, в 36 градусов жары и не заметил, что блогу 9го июля исполнилось два года.
 Хочется подвести итоги 2х лет активного участия в сообществе.
- Написано 260 постов в блоге
- 4500 комментариев на форуме VMware - общее 19е место и 1е в русскоязычном разделе
- Global User Moderator форума VMware
- дважды VMware vExpert
- VMware User Group Russia Leader (вместе с Михаилом Михеевым)
- Организовано 2 крупнейших встречи VMUG Russia, собравших в Москве почти по 100 человек
- Открыта первая региональная VMUG в Нижнем Новгороде
Подписаться на:
Сообщения (Atom)

 Сообщения


